
2026-09-26
뮤직비디오 한 편을 코드로 조립한 방법 — 딸깍 MV 제작기
Suno 노래, GPT Image 그림, Seedance 영상을 재료로 쓰고 모든 프레임은 JavaScript가 그렸습니다. 186초 뮤직비디오를 64컷으로 조립한 구조와 실패를 실제 구현으로 풀어봅니다.
AI 뮤직비디오는 영상 모델에 노래를 넣고 기다리는 작업이 아닙니다.
생성 모델은 재료를 만들고, 편집 판단은 코드가 합니다.
딸깍은 이 원칙으로 만든 186초짜리 K-pop 뮤직비디오입니다.
노래는 Suno로 만들었습니다. 주인공 해바는 GPT Image로 그렸고, 춤은 Seedance 2.5로 찍었습니다. 하지만 화면에 나가는 프레임 4,469장은 전부 브라우저 안의 JavaScript가 그렸습니다. AI가 만든 결과물은 모두 레이어 한 장으로 들어갑니다.
이 글은 그 구조를 순서대로 따라갑니다. 수치는 2026년 9월 26일 v1 렌더 기준입니다.
「딸깍」 뮤직비디오 전체(3분 6초)입니다. 소리를 켜고 보시길 권합니다.
모든 것은 노래의 시계에서 시작합니다
뮤직비디오의 모든 이벤트는 노래의 시간에 묶입니다. 컷, 조명, 입 모양, 가사가 전부 그렇습니다. 그래서 첫 작업은 노래를 정확한 시계로 바꾸는 일이었습니다.
Suno는 가사 정렬 파일을 줍니다. 그런데 이 파일은 실제로 부른 것과 다릅니다. 시트에는 "딸깍"이 두 번인데 실제로는 세 번 부르고, 부르지 않은 반복 줄이 9개 들어 있었습니다. 리드 보컬 스템을 whisper로 구간마다 다시 듣고, 실제로 부른 가사 76줄로 정렬을 새로 만들었습니다.
템포도 고정이 아니었습니다. A2 테이크는 126.2 BPM에서 127.3 BPM으로 조금씩 빨라집니다. 고정 BPM 그리드로 계산하면 박이 최대 164 ms 어긋납니다. 박을 하나씩 측정한 비트맵을 쓰면 오차는 RMS 5 ms입니다.
이 두 가지가 합쳐지면 코드에서 이런 질문을 할 수 있습니다.
BAR(26)                        // 26번째 마디가 시작하는 초
findLine('며칠 뒤 점수')          // 그 가사 줄의 시작과 끝
sylOnsets(line, '깍')           // 그 줄에서 "깍"을 부른 순간들
영상 코드 어디에도 초를 직접 쓰지 않았습니다. 테이크를 바꾸면 모든 컷이 새 노래에 맞춰 다시 계산됩니다. 무대 조명이 "깍"마다 번쩍이고, 퍼펫이 "깍"마다 손가락을 튕기는 것도 이 음절 시계 덕분입니다.
프레임은 시간의 함수입니다
렌더러는 p5.js와 p5.brush를 올린 웹페이지 하나입니다. Node 스크립트가 headless Chrome을 띄우고, 시간 t를 넘기면 그 순간의 프레임 한 장을 받습니다.
핵심 규칙은 하나입니다. 같은 t는 언제 그려도 픽셀 단위로 같아야 합니다.
그래서 난수는 매 프레임, 레이어마다 (프레임 번호, 레이어)로 다시 시드합니다.
머리카락이 흔들리는 스프링도 이전 프레임의 상태를 기억하지 않습니다. 과거 움직임을 필터로 다시 계산합니다.
이 규칙이 있어서 프레임을 아무 순서로나 그릴 수 있습니다. 워커 두 개가 나눠 그리고, 중간에 멈춰도 이어서 그립니다. 실제로 첫 렌더는 2,000번째 프레임 근처에서 Chrome이 죽었습니다. 재시작한 렌더는 남은 프레임만 채웠고, 결과는 처음부터 그린 것과 같습니다.
한 프레임은 일곱 레이어를 순서대로 쌓아 만듭니다.
set → type → footage → chars → fx → inserts → grade
배경   큰 글자   영상 속 인물  퍼펫   관객   밈·가사   종이 질감
글자 레이어가 인물보다 먼저 그려지기 때문에, 큰 "딸깍"이 해바 뒤에 깔립니다.
마지막 grade는 모든 장면에 같은 종이 결과 그레인을 입힙니다. 재료는 달라도 한 사람이 그린 그림처럼 보이게 하는 장치입니다.
화면에는 네 가지 재료가 들어갑니다
배경은 그림 한 장에 빛만 더합니다
장소는 다섯 곳입니다. 해바라기 무대, 새벽 두 시의 옥탑방, 칠판 강당, 여의도 옥상, 감나무 언덕입니다. 장소마다 GPT Image 그림 한 장만 씁니다.
그림에서 발광하는 부분을 마스크로 분리했습니다. LED 꽃잎 18장, 전구, 네온, 창문 같은 것들입니다. 렌더할 때는 그림 위에 빛만 다시 더합니다. 꽃잎이 박에 맞춰 돌고, 빔이 흔들리고, 클릭마다 플래시가 터집니다. 배경 그림 자체는 한 번도 다시 생성하지 않았습니다.
노래하는 얼굴은 한 장의 그림을 움직입니다
해바가 노래하는 클로즈업은 영상이 아니라 퍼펫입니다. 원화 한 장을 몸, 머리카락, 얼굴, 장신구로 잘랐습니다. 입 모양, 눈, 팔 제스처, 3/4 고개는 편집 모델로 만든 스프라이트입니다. 각 조각을 격자 메시에 올리고 매 프레임 구부립니다. Live2D와 같은 방식입니다.
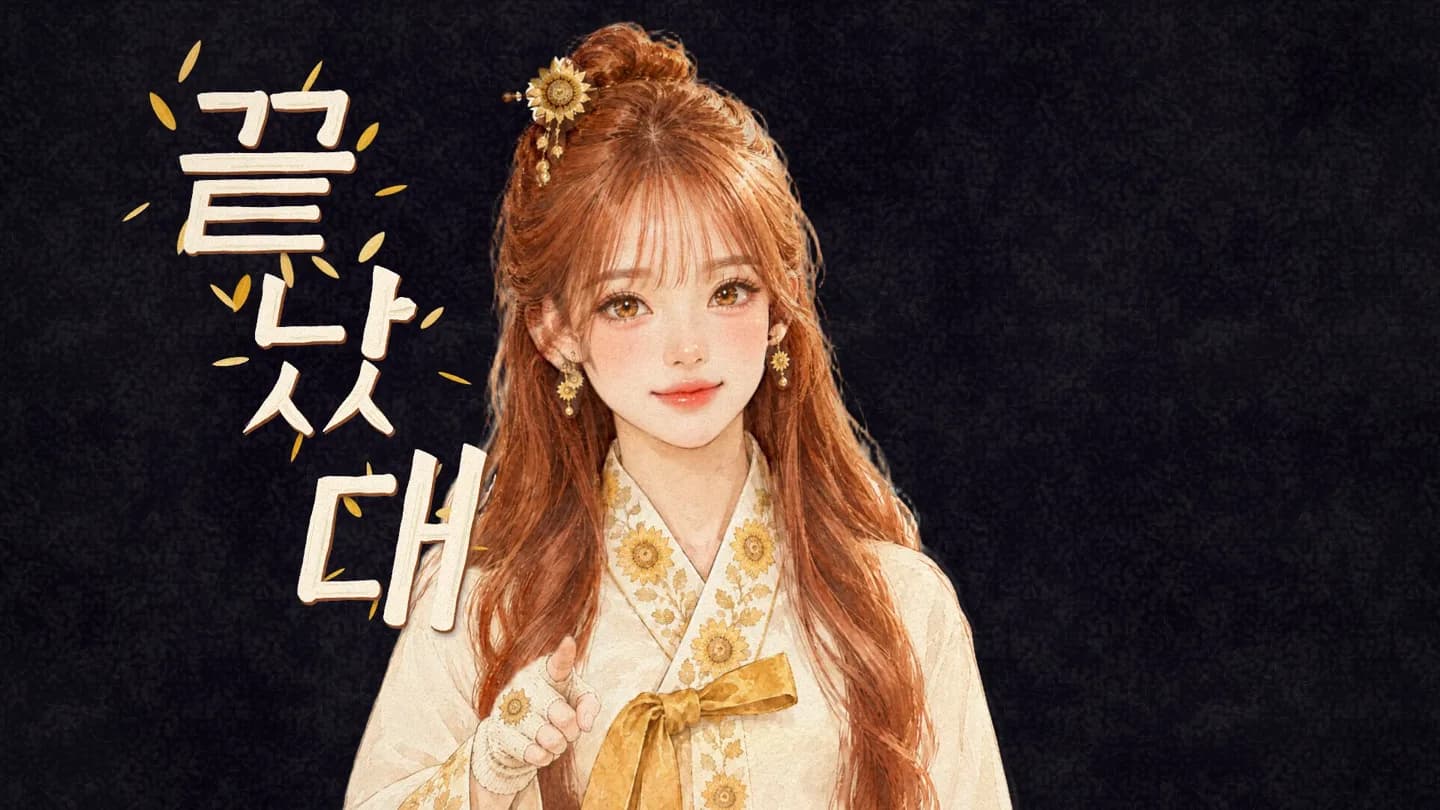
"딸깍 한 번에 (끝났대!)"의 응답 순간입니다. 갱 보컬이 나오는 동안 배경이 검정으로 넘어가고, 퍼펫의 입은 닫힙니다.
입은 리드 보컬 스템의 모음 트랙으로 움직입니다. 음절의 모음 자모를 보고 ㅏ, ㅗ, ㅜ, ㅣ 입 모양을 고릅니다. 50 ms짜리 "딸깍"에서도 입이 최소 2.5프레임은 벌어지게 보정했습니다. 고개와 눈 깜빡임은 Seedance로 찍은 얼굴 모캡 6개에서 가져옵니다. 훅, 콜, 랩, 브리지마다 다른 테이크를 씁니다.
제스처는 가사로 정합니다. "딸깍"이 든 줄은 클릭 포즈로 "깍"마다 탭하고, "딸깍 한 번에"는 "한"에서 핑거건을 합니다. 나머지 줄은 포인트, 엄지, 손 흔들기, 하트 중 하나를 고릅니다.
춤은 Seedance 영상을 오려서 끼웁니다
전신 댄스는 Seedance 2.5 720p 영상 8컷입니다. 각 컷은 무대나 언덕 그림을 잘라 만든 첫 프레임에서 시작하기 때문에, 그림체와 배경이 플레이트와 같습니다.
영상은 그대로 쓰지 않고 인물을 오려냅니다. BiRefNet 모델을 Apple GPU에서 돌려 프레임마다 알파 매트를 만듭니다. 한 컷에 약 80초 걸립니다. 모델이 가끔 LED 꽃잎을 인물로 착각합니다. 그래서 포즈 추정으로 그린 팔다리 영역 밖은 잘라내고, 앞뒤 한 프레임과 중앙값을 내서 가장자리 떨림을 줄였습니다.
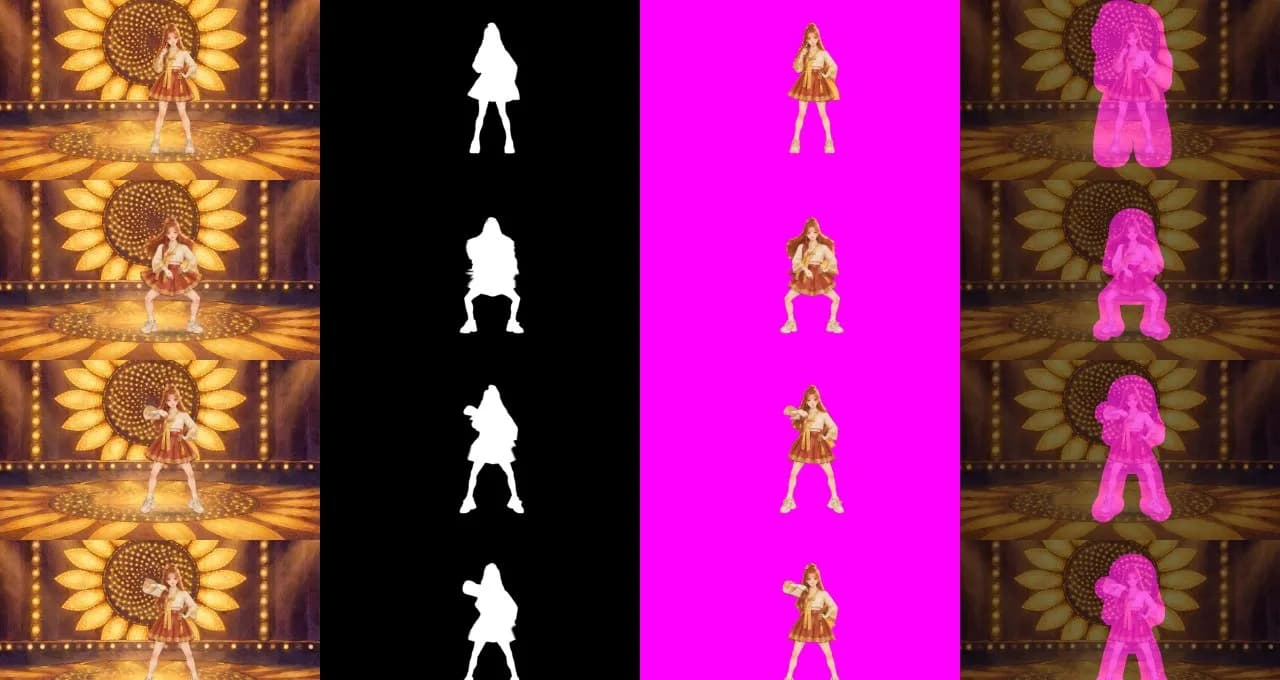
S09 컷의 매트 검수 시트입니다. 왼쪽부터 원본, 매트, 오려낸 인물, 매트를 원본 위에 겹친 모습입니다.
합성은 샌드위치입니다. 맨 아래에 영상 원본을 깔고, 그 위에 큰 글자를 그리고, 맨 위에 오려낸 해바를 올립니다. 그러면 글자가 무대 앞, 인물 뒤에 끼어 보입니다.
크루는 댄서 한 명을 여섯 명으로 만듭니다
백업 댄서 씨앗 크루는 Seedance로 찍은 한 명입니다. 단색 청록 배경에서 찍어서 색으로 쉽게 오려냅니다. 이 한 컷을 V자 대형으로 여섯 번 배치합니다. 줄마다 2프레임씩 늦춰서 동작이 물결처럼 퍼지고, 오른쪽 셋은 좌우를 뒤집습니다.
영상 속 동작은 박과 정확히 맞지 않습니다. 그래서 빠른 동작이 끝나는 순간을 찾아 가장 가까운 박에 핀으로 고정하고, 그 사이 재생 속도를 0.72배에서 1.4배 사이로 늘이거나 줄입니다.
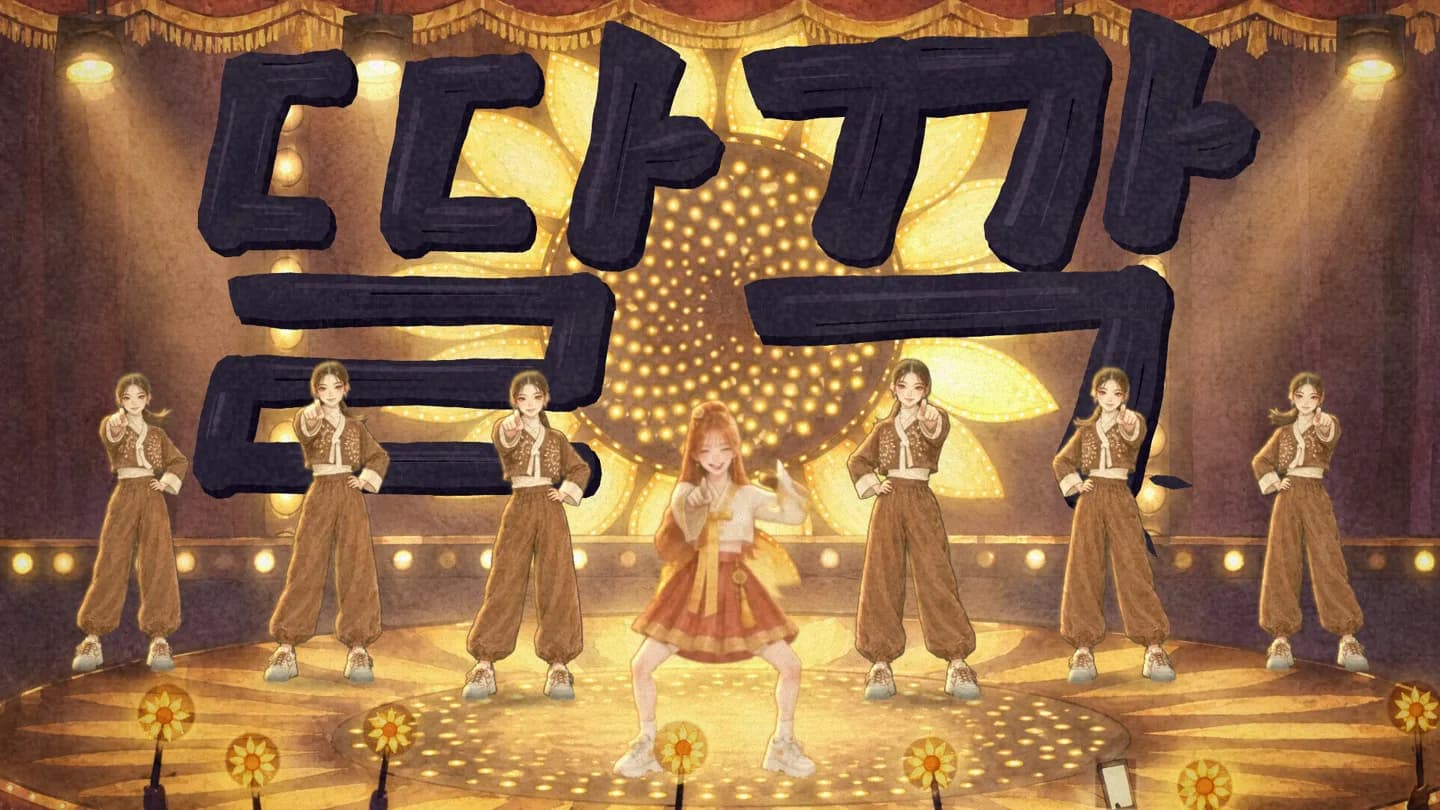
크루 여섯 명은 모두 같은 댄서 한 컷입니다. 가운데 해바는 댄스 컷의 매트를 무대 그림 위에 올린 것입니다.
편집은 64개의 함수입니다
가사 타이포는 76줄 전부에 대해 미리 계획해 둔 파일이 있습니다. 줄마다 모드가 정해져 있습니다. 화면을 채우는 HERO, 도장처럼 찍히는 STAMP, 갱 응답을 받는 CALL, 단어를 자르는 CHOP 같은 것들입니다.
편집 파일은 이 재료들을 64개 샷으로 엮습니다. 샷 하나는 한 줄짜리 함수 호출입니다.
shots.push(wide('CH1-1', BAR(26), 'S09'));                          // 댄스 와이드 2마디
shots.push(crew('CH1-1c', BAR(28), D1, 'stage', { haeba: 'S09' }));  // 크루 대형 1마디
shots.push(pup('CH1-3', BAR(32), 'stage', { flips: true }));         // 콜 클로즈업
코러스는 와이드 두 마디, 크루 한 마디, 와이드 한 마디, 인서트, 콜 클로즈업, 크루 히트 순서로 자릅니다. 랩은 퍼펫과 밈을 한 마디씩 번갈아 씁니다. 권한 문, AGI 점수판, GPU 컨페티, 특이점 역 표지판 같은 밈 인서트도 전부 JavaScript 도형입니다.
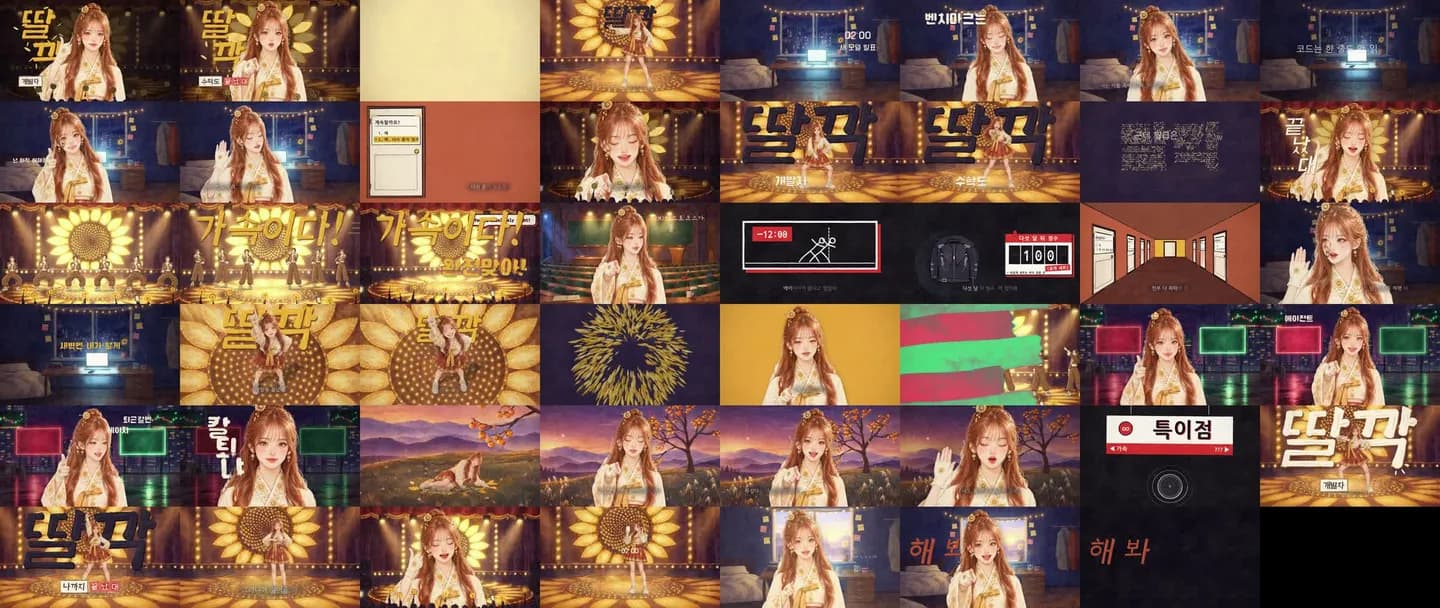
완성본을 4초 간격으로 뽑은 컨택트 시트입니다. 무대, 옥탑방, 강당, 여의도, 언덕 순서로 장소가 바뀝니다.
렌더는 프레임당 평균 약 70 ms입니다. 16:9 한 벌이 3분 남짓에 나옵니다. 9:16은 같은 장면을 세로 캔버스에 벡터로 다시 그립니다. 글자와 도형은 선명하지만, 720p 댄스 영상은 확대되기 때문에 조금 부드러워집니다. 59초 쇼츠 3종은 샷 리스트에 적어 둔 구간을 9:16 완성본에서 잘라 이었습니다. 이음새마다 8 ms 페이드를 넣어 클릭 잡음을 막았습니다.
실패가 구조를 정했습니다
이 구조는 처음부터 설계한 것이 아닙니다. 실패 세 번이 만들었습니다.
첫째, 코드로 그린 캐릭터는 예쁘지 않았습니다. 브러시로 얼굴을 직접 그린 버전은 리뷰에서 4점이었습니다. "카툰 필터에 스티커를 붙인 느낌"이었습니다. 그래서 얼굴은 이미지 모델이 그린 원화를 그대로 쓰고, 코드는 그 그림을 움직이기만 합니다.
둘째, Seedance는 노래에 입을 맞추지 못했습니다. 노래를 오디오 레퍼런스로 넣어도 입 모양은 맞지 않았고, 춤도 박에 맞지 않았습니다. 그래서 노래는 퍼펫이 부르고, 영상은 춤만 맡고, 박은 코드가 맞춥니다.
셋째, 크레딧을 너무 많이 썼습니다. 이 프로젝트에 Higgsfield 크레딧 약 1,545를 썼습니다. 그중 실사 모캡 426은 캐릭터 방향이 바뀌면서 화면에 나가지 않았습니다. 마지막 조립은 크레딧 0으로 끝냈습니다. 이미 만든 재료만으로 64컷을 채웠습니다.
작은 실패도 있었습니다. 노트북 화면이나 칠판 안에 가사를 넣는 설계였는데, 실제 화면 크기에서는 읽히지 않았습니다. 전부 화면 위 글자로 바꿨습니다.
모델에게 맡길 것과 코드에 맡길 것을 나눕니다
이 작업에서 남은 기준은 단순합니다.
모델은 한 장, 한 컷의 품질을 책임집니다. 예쁜 얼굴, 그림체, 자연스러운 몸의 움직임은 모델이 코드보다 잘 만듭니다. 코드는 시간과 반복을 책임집니다. 박, 음절, 컷 포인트, 같은 장면의 재현, 수천 프레임의 일관성은 코드가 모델보다 정확합니다.
둘을 섞지 않으면 수정도 쉬워집니다. 컷 하나를 바꾸는 데 크레딧이 들지 않습니다. 함수 한 줄을 고치고 그 구간만 다시 렌더하면 됩니다.
AI로 영상을 만들고 있다면, 모델에게 한 번에 완성본을 요구하기 전에 이 질문을 먼저 해 보시길 권합니다. 이 장면에서 모델만 할 수 있는 일은 무엇이고, 코드가 더 정확하게 할 수 있는 일은 무엇인가.
사용한 도구
- 노래: Suno (테이크 A2, 186.2초), 가사 검증 whisper large-v3
- 그림: GPT Image 2.5 (캐릭터 원화, 장소 5곳)
- 영상: Seedance 2.5 via Higgsfield (댄스 8컷, 크루 4컷, 얼굴 모캡 6컷)
- 매트: BiRefNet_lite (PyTorch MPS), MediaPipe 포즈
- 렌더: p5.js 2.3.3, p5.brush 2.2.3, Puppeteer, headless Chrome, ffmpeg