2026-10-23
판정만 하는 AI를 시험했습니다 — 75배 싸고 16배 빨랐지만 3점이 모자랐습니다
OpenAI가 10월 22일 정식 출시한 Decisions API로 AutoKliq의 썸네일 판정기를 옮길 수 있는지, 공개 영상 쌍 5,740개로 검증했습니다. 75배 싸고 16배 빨랐지만 정확도가 3점 낮아 옮기지 않았습니다.
2026년 10월 22일, OpenAI가 Decisions API를 정식으로 내놓았습니다. 이미지와 글을 보고 판단만 하는 모델입니다. 긴 글을 쓰지 않고, 정해 둔 보기 중 하나를 고르거나 어떤 문장이 참일 확률을 숫자로 답합니다. 출력에는 요금이 없고, 입력 100만 토큰에 0.1달러입니다.
저는 이 API를 기다리고 있었습니다. 제가 만드는 AutoKliq에는 썸네일과 제목을 한 세트로 보고, 두 세트 중 어느 쪽이 시청 시간을 더 많이 얻을지 고르는 판정기가 있습니다. 지금은 Claude Opus가 판정합니다. 한 쌍을 판정하는 데 0.025달러가 들고, 호출 한 번에 4초쯤 걸립니다. 판정기가 싸고 빨라지면 같은 예산으로 훨씬 많은 후보를 비교할 수 있습니다.
출시 당일 Claude Code에 세 가지를 확인해 달라고 했습니다. 지금 쓰는 판정기와 비교해서 「비슷한 수준까지 쓸 수 있는지」, 「가격은 얼마나 더 저렴한지」, 「속도도 빠르면서 심지어 더 잘 만들 수 있는지」였습니다. 기대도 숨기지 않았습니다. 「된다면 대박일것같아. 엄청 싸고 빠르고.」
결론부터 말씀드리면, 옮기지 않았습니다. Decisions API는 75배 싸고 16배 빨랐지만, 정확도가 3점 모자랐습니다.
판정기는 같은 시험지로만 비교합니다
판정기의 실력은 공개 영상으로 잽니다. 한국어 채널 158개와 영어 채널 205개에서 공개 영상 58,602개를 모았습니다. 같은 채널에서 30일 안에 올라온 두 영상 중, 채널 평소 대비 성과가 1.4배 이상 벌어진 쌍만 골랐습니다. 이렇게 만든 쌍이 5,740개입니다. 판정기는 두 영상의 썸네일과 제목만 보고 어느 쪽이 잘됐는지 맞힙니다.
다른 영상끼리 비교하는 시험이라 주제와 시기도 섞여 있습니다. 그래서 점수 하나보다, 같은 쌍에서 두 판정기가 낸 점수의 차이를 봅니다. 지금 판정기인 Opus는 이 시험의 홀드아웃 4,187쌍에서 59.7%를 맞힙니다. 동전 던지기는 50%입니다.
Decisions API에는 Opus가 받는 설명과 이미지를 그대로 줬습니다. 바꾼 것은 답하는 형식뿐입니다.
질문 방식은 여섯 가지를 시험했습니다
Decisions API는 세 가지 형식으로 답합니다. 보기 중 하나를 고르고 보기마다 확률을 주는 선택지 형식, 문장이 참일 확률을 주는 참·거짓 형식, 미리 정한 단계 중 어디에 해당하는지 답하는 점수 형식입니다.
이 형식으로 질문 방식을 여섯 가지 만들었습니다.
- 선택지 — 두 세트를 함께 보여 주고 시청 시간을 더 얻을 쪽을 고르게 합니다.
- 참·거짓 — 같은 장면에서 「1번 세트가 시청 시간을 더 많이 얻는다」가 참일 확률을 묻습니다.
- 종합 점수 — 세트를 하나씩 보여 주고, 채널의 평소 영상보다 얼마나 잘될지 다섯 단계로 매깁니다.
- 기준 7개 점수 — 종합 점수에 여섯 가지 기준을 더해 따로 매긴 뒤 합칩니다. 기준은 한눈에 읽히는지, 궁금증을 만드는지, 약속하는 결과가 구체적인지, 감정과 긴장감, 제목과 썸네일이 서로 보완하는지, 채널 시청자가 찾는 주제인지입니다.
- 붙인 배치 두 가지 — 선택지와 참·거짓 질문에서 썸네일 바로 옆에 그 세트의 번호와 제목을 붙여 보여 줍니다.
결과를 보기 전에 규칙부터 정했습니다
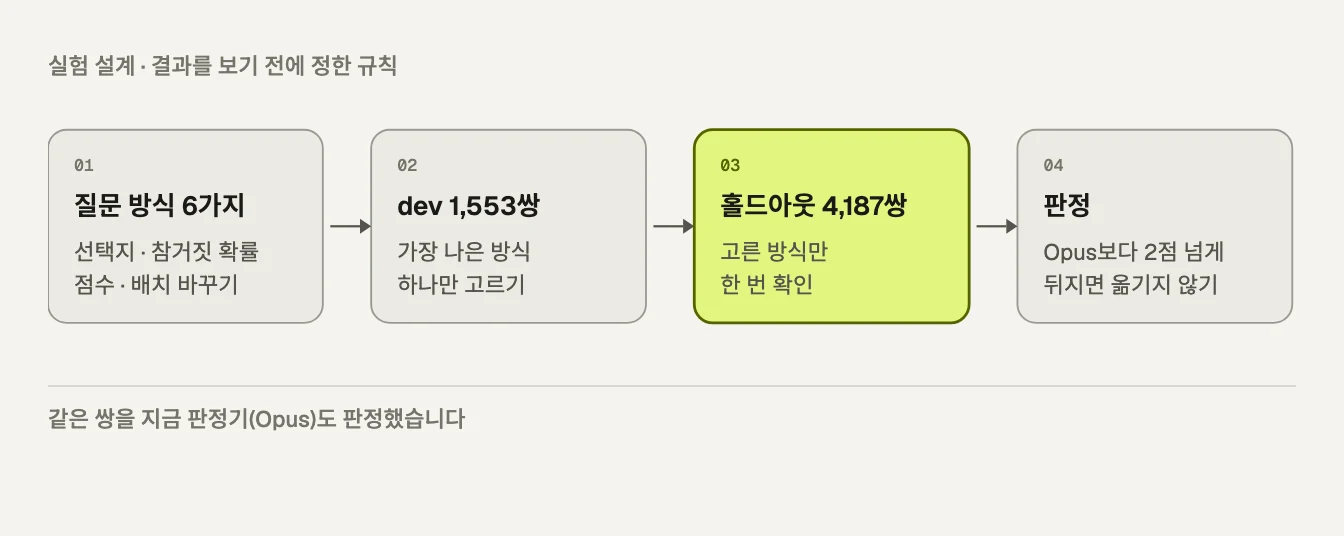
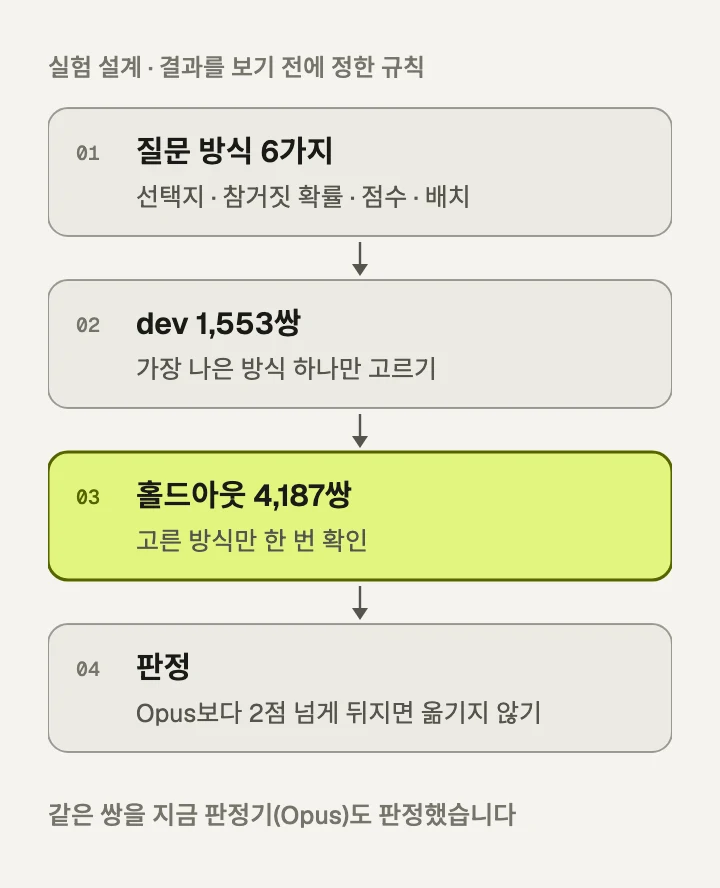
여러 방식을 시험하면 우연히 좋아 보이는 방식이 하나쯤 나옵니다. 그래서 순서를 먼저 정했습니다.
여섯 방식은 dev 쌍 1,553개에서만 비교하고, 가장 나은 하나만 홀드아웃 4,187쌍에서 한 번 확인합니다. 홀드아웃에서 Opus보다 2점 넘게 뒤질 가능성이 남으면 옮기지 않습니다. 정확히는 Opus와의 차이에 대한 95% 신뢰구간의 아래쪽 끝이 −2점보다 낮으면 옮기지 않습니다.
이 규칙은 실험 중에 실제로 일을 했습니다. 썸네일 옆에 제목을 붙인 배치는 dev에서 다른 방식보다 1.9점 앞서 보였습니다. 홀드아웃에서는 그 차이가 사라졌습니다. dev 숫자만 보고 골랐다면 존재하지 않는 개선을 믿고 결정했을 것입니다.
75배 싸고 16배 빨랐습니다
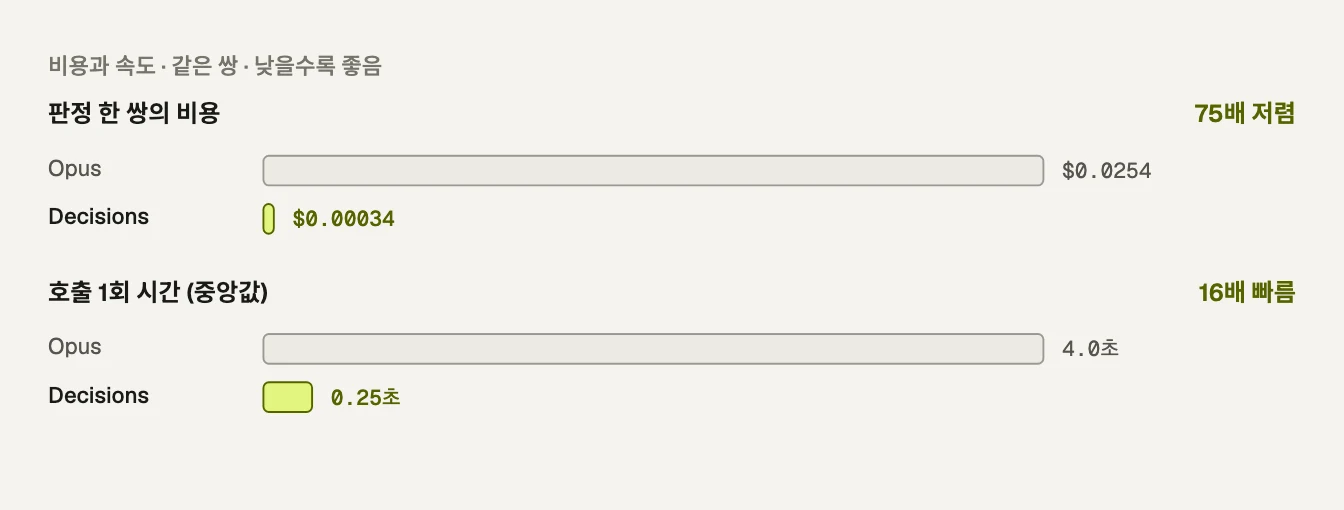
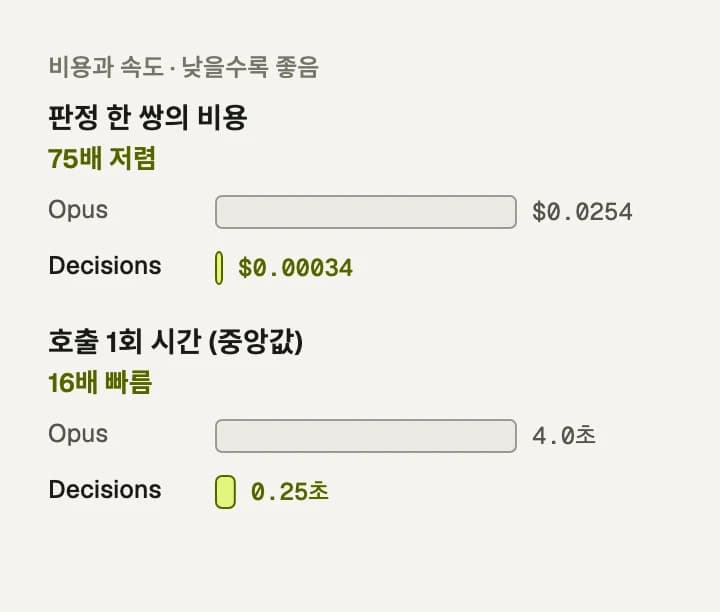
한 쌍을 판정하는 데 Opus는 0.0254달러, Decisions는 0.00034달러가 들었습니다. 75배 차이입니다. 호출 한 번의 시간은 중앙값 기준으로 Opus 4.0초, Decisions 0.25초였습니다. 이번 실험에서 Decisions를 3만 2천 번쯤 불렀는데 5.9달러가 들었습니다. 홀드아웃 한 번을 Opus로 판정하면 100달러가 넘습니다.
같은 질문에는 늘 같은 답을 냈습니다. 100번을 다시 물었을 때 확률까지 그대로였습니다. 점수 형식은 말하는 확률도 정직했습니다. 기준 7개 점수가 말한 확률은 실제 적중률과 평균 0.8점 차이였고, Opus는 3.8점 차이였습니다.
그런데 3점이 모자랐습니다
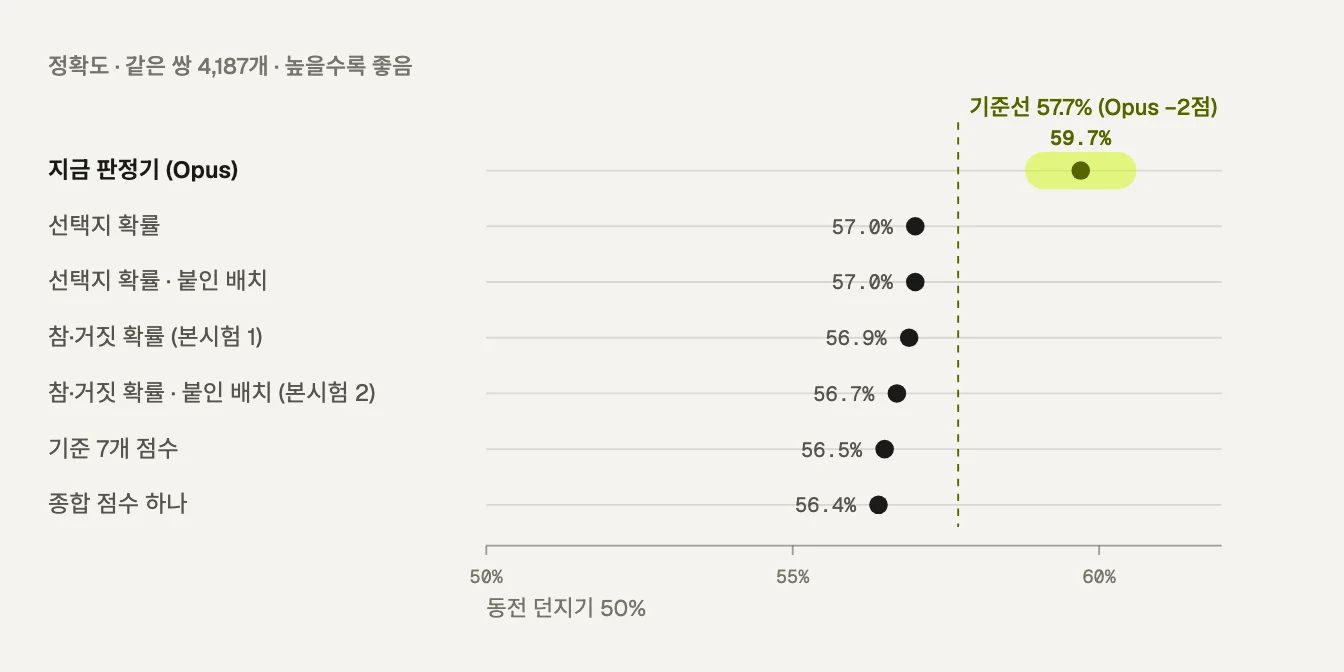
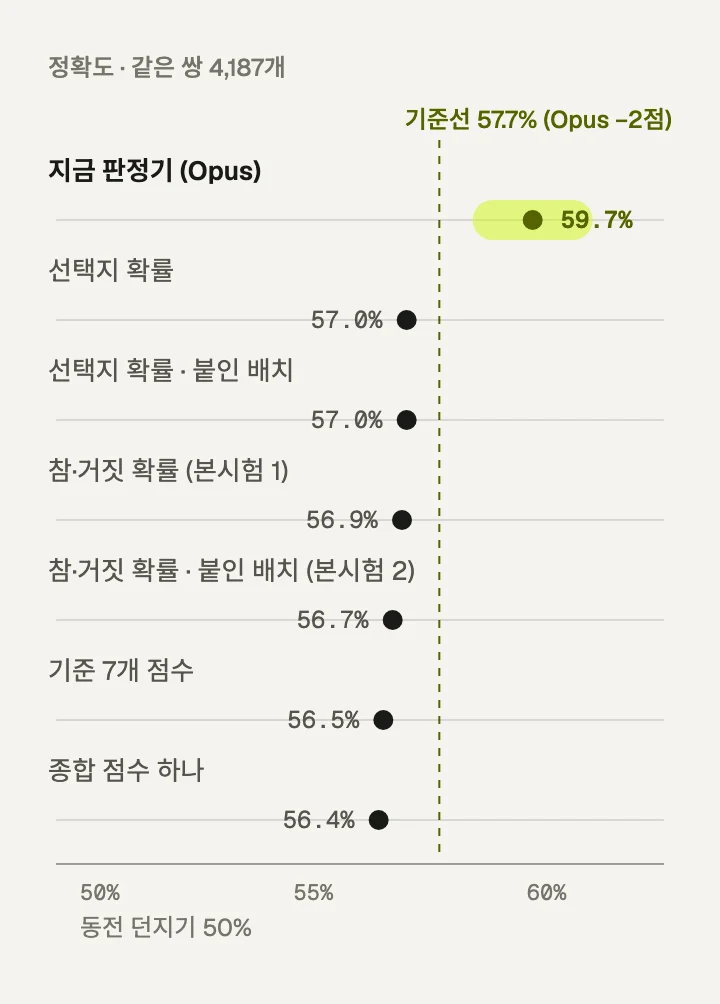
여섯 방식이 모두 56.4%에서 57.0% 사이에 모였습니다. Opus는 59.7%입니다. 미리 정한 두 번의 본시험도 기준을 넘지 못했습니다. 참·거짓 질문은 Opus보다 2.8점 낮았고(95% 구간 −4.4 ~ −1.2점), 제목을 붙인 참·거짓 배치는 3.0점 낮았습니다(−4.6 ~ −1.4점). 질문을 바꿔서 메울 수 있는 차이가 아니라 모델의 차이입니다.
3점은 작아 보이지만 판정기에게는 큰 차이입니다. 동전 던지기보다 Opus는 9.7점, Decisions는 7점쯤 더 맞힙니다. Decisions는 판정 실력의 70%쯤을 75분의 1 가격에 냅니다.
순서를 바꾸면 답이 뒤집혔습니다
가장 큰 약점은 순서였습니다. 두 세트를 보여 주고 고르게 하면 Decisions는 69%의 경우 첫 번째 세트를 골랐습니다. 「1번 세트가 더 낫다」가 참인지 물으면 31%의 경우에만 참이라고 답했습니다. 질문 형식에 따라 서로 반대쪽으로 기울었습니다. 같은 두 세트의 순서만 바꿨을 때 답이 뒤집힌 쌍이 42%였습니다. Opus는 14%였습니다.
썸네일 옆에 번호와 제목을 붙여 어느 그림이 몇 번인지 분명히 해도 나아지지 않았습니다. Decisions가 확신할 때만 쓰고 나머지는 Opus에 맡기는 조합도 dev에서 시험했습니다. Decisions가 가장 확신한 쌍에서도 Opus가 같거나 더 잘 맞혀서, Opus 혼자보다 나은 조합은 없었습니다.
같은 영상의 A/B 결과로도 확인하려 했습니다. AutoKliq에 올라온 Test & Compare 결과 중 세트마다 제목까지 기록된 것은 7개 테스트, 14쌍뿐이었습니다. 이 정도로는 어느 쪽이 낫다고 판단할 수 없습니다.
판정은 Opus에 두고, 거르기는 Decisions에 맡겨 볼 만합니다
판정기는 Opus로 둡니다. 크리에이터가 보고 결정하는 판정에서는 3점이 중요합니다.
Decisions가 쓸모없다는 뜻은 아닙니다. 0.25초에 답하고 75분의 1 가격이면 할 수 있는 일이 따로 있습니다. 후보가 수십 개일 때 먼저 걸러 내고 Opus가 마지막 몇 개만 판정하는 일, 업로드할 때마다 패키지 점수를 매겨 성과 예측의 재료로 쓰는 일, 썸네일을 고치는 동안 바로 반응을 보여 주는 일입니다. 셋 다 이번 실험의 범위 밖이라 각각 따로 검증합니다.
이번 실험에는 6.65달러가 들었습니다. 새 모델이 나올 때마다 이 정도 비용으로 같은 시험지를 다시 풀게 할 수 있습니다. 싸고 빠른 모델은 앞으로도 계속 나옵니다. 남는 경쟁력은 모델이 아니라, 새 모델을 같은 질문으로 시험할 수 있는 시험지입니다.
출처
- OpenAI · Decisions API 문서 (2026-10-22 확인)
- TechCrunch · 2026-10-22
- 실험 수치: AutoKliq 판정기 벤치마크, 2026-10-22 (홀드아웃 4,187쌍, dev 1,553쌍)